OmniHuman 2.0: говорящее видео по фото и аудио с русской речью
100 ₽ в подарок при регистрации
Промпт
Wide editorial hero image, 16:9. Scene: deep near-black studio space #0A0A0F with a soft amber #F5A623 glow near the horizon. Subject: a matte black vertical portrait frame on a thin stand; inside the frame an abstract minimal line-art face drawn with thin glowing amber strokes, lips slightly parted; a smooth continuous amber voice waveform flows from a sleek studio microphone on the left into the frame on the right, as if the sound drives the face. Details: photoreal 3D render, matte black surfaces, thin luminous amber strokes, gentle volumetric haze, soft rim light. Composition: left-to-right flow, eye-level, wide framing, generous negative space, high contrast, calm mood. Constraints: absolutely NO text, NO letters, NO logos, NO numbers, NO watermark, no brand marks, NO photorealistic human faces, NO people, no silhouettes. Palette: near-black background #0A0A0F with amber #F5A623 accents only. Use: blog article cover about an AI model that makes a talking video from one photo and an audio file.
Главное:
- OmniHuman 2.0 от ByteDance делает говорящее видео из одного фото и аудиофайла: губы, мимика и жесты идут за речью.
- В Студии IskraGen один режим «Фото + аудио → видео»: фото человека, аудио MP3 или WAV на 4–300 секунд, промпт по желанию.
- В нашем тесте на русской речи рот следует за звуками, лицо без искажений; на слух ролик не проверяли.
- Цена считается за секунду аудио, неполная секунда округляется вверх.
- Если своего голоса нет, удобнее видеомодель, которая сама озвучивает реплику из промпта.
OmniHuman — нейросеть ByteDance, которая превращает один портрет и аудиозапись в видео, где человек с фото говорит этим голосом. Внешность берётся со снимка, а движение губ, мимику и жесты задаёт звук. Мы добавили OmniHuman 2.0 в Студию IskraGen и проверили модель на русской речи: ниже исходный портрет, запись голоса, готовый ролик и честный разбор того, что получилось и чего мы не проверяли.
Что умеет OmniHuman 2.0 и кому нужно говорящее видео по фото
OmniHuman 2.0 делает говорящее видео по одному фото человека и одному аудиофайлу: длина ролика равна длине записи, а губы, лицо и руки двигаются под речь. Это и есть то, что в поиске называют «говорящее фото нейросеть»: снимок, который заговорил вашим текстом и вашим голосом.
Главное отличие от обычного оживления фото — источник движения. Модели «картинка в видео» придумывают движение по текстовому описанию, а OmniHuman берёт его из звука. В документации kie это сформулировано прямо: аудио управляет движением и синхронизацией губ. Поэтому OmniHuman нейросеть не нужно объяснять словами, что человек должен говорить: всё, что прозвучит в файле, станет движением рта.
Линейка у модели длинная. Первая версия, OmniHuman-1, описана в научной статье на arXiv в феврале 2025 года: авторы показали, что одна модель справляется и с крупным планом, и с портретом по пояс, и с фигурой в полный рост, причём умеет и говорить, и петь. Версия 1.5 (август 2025 года) добавила смысловую разметку движения через языковые модели, чтобы жесты отвечали эмоции и смыслу фразы, а не только ритму звука.
OmniHuman 2.0, по описанию kie, растягивает ролик до 5 минут, то есть до 300 секунд. У версии 1.5, по данным kie, длительность была до 60 секунд, зато разрешение доходило до 1080p; вторая версия отдаёт 720p. На странице BytePlus в версии 2.0 отдельно подчёркивают динамичное движение, эмоциональную подачу, сцены с несколькими персонажами и управление жестами и камерой.
Кому это пригодится:
- Блогерам и ведущим каналов. Короткое вступление или анонс, где говорит портрет ведущего, без съёмки в студии.
- Маркетологам. UGC-ролики и рекламные обращения от лица персонажа, которого не нужно снимать.
- Авторам курсов. Обучающие видео, подкасты и интервью, где запись голоса уже есть, а видеоряда нет.
- Музыкантам. Поющий персонаж под готовый трек: kie прямо называет такие ролики среди сценариев модели.
Если у вас есть запись голоса и подходящий портрет, OmniHuman закрывает задачу целиком. Если записи нет, её можно сделать озвучкой текста — именно так мы готовили наш тест.
Как устроен OmniHuman 2.0 в Студии IskraGen
В Студии IskraGen у OmniHuman 2.0 один режим — «Фото + аудио → видео», и в нём два обязательных поля, необязательный промпт и переключатель водяного знака. Модель живёт в категории видео, её страница — OmniHuman 2.0 в каталоге.
«Фото человека». Одно фото, поле обязательное. Форматы — JPEG, PNG, WEBP, GIF, TIFF и BMP, размер до 30 МБ. Под полем есть подсказка: «Фото анфас, лицо хорошо видно; пропорции от 0.4 до 2.5, стороны 300–6000 px». Это совет, а не проверка: Студия не определяет, есть ли на снимке лицо, и не меряет пропорции.
«Аудио». Тоже обязательное поле. Принимается MP3 или WAV длительностью от 4 до 300 секунд и размером до 15 МБ. Подсказка в форме: «Движение и синхронизация губ берутся из аудио». Длину записи меряет сервер, и он же отклоняет то, что не проходит в рамки. Сообщения об ошибке говорят прямо: «Аудио больше 15 МБ», «Аудио короче 4 секунд», «Аудио длиннее 300 секунд» или «Не удалось определить длительность аудио». Ссылку на чужой сайт вставить нельзя — Студия принимает только файл, загруженный через неё, и иначе ответит «Загрузите собственный исходник через Студию».
«Промпт (необязательно)». До 300 символов. Если оставить поле пустым, промпт провайдеру вообще не отправляется, и движение целиком задаёт аудио. По документации kie текст промпта уточняет сцену, движение персонажа и камеры, а понимает модель китайский, английский, японский, корейский, испанский и индонезийский. Русского в этом списке нет, поэтому промпт для OmniHuman лучше писать по-английски. Слишком длинный текст Студия не пропустит с сообщением «Промпт длиннее лимита модели».
«Водяной знак». По умолчанию выключен. Подсказка: «Метка провайдера в углу видео. На цену не влияет». У самого провайдера по документации метка включена по умолчанию, но Студия отправляет запрос без неё, пока вы сами не включите переключатель.
Поля длительности у OmniHuman нет. Ролик всегда длится столько же, сколько аудио, поэтому, если нужно видео покороче, обрежьте запись до загрузки.
Порядок работы простой:
- Откройте модель в Студии и загрузите портрет в поле «Фото человека».
- Загрузите запись в поле «Аудио».
- При желании впишите короткий промпт по-английски про сцену или камеру.
- Проверьте цену на кнопке и запустите генерацию.
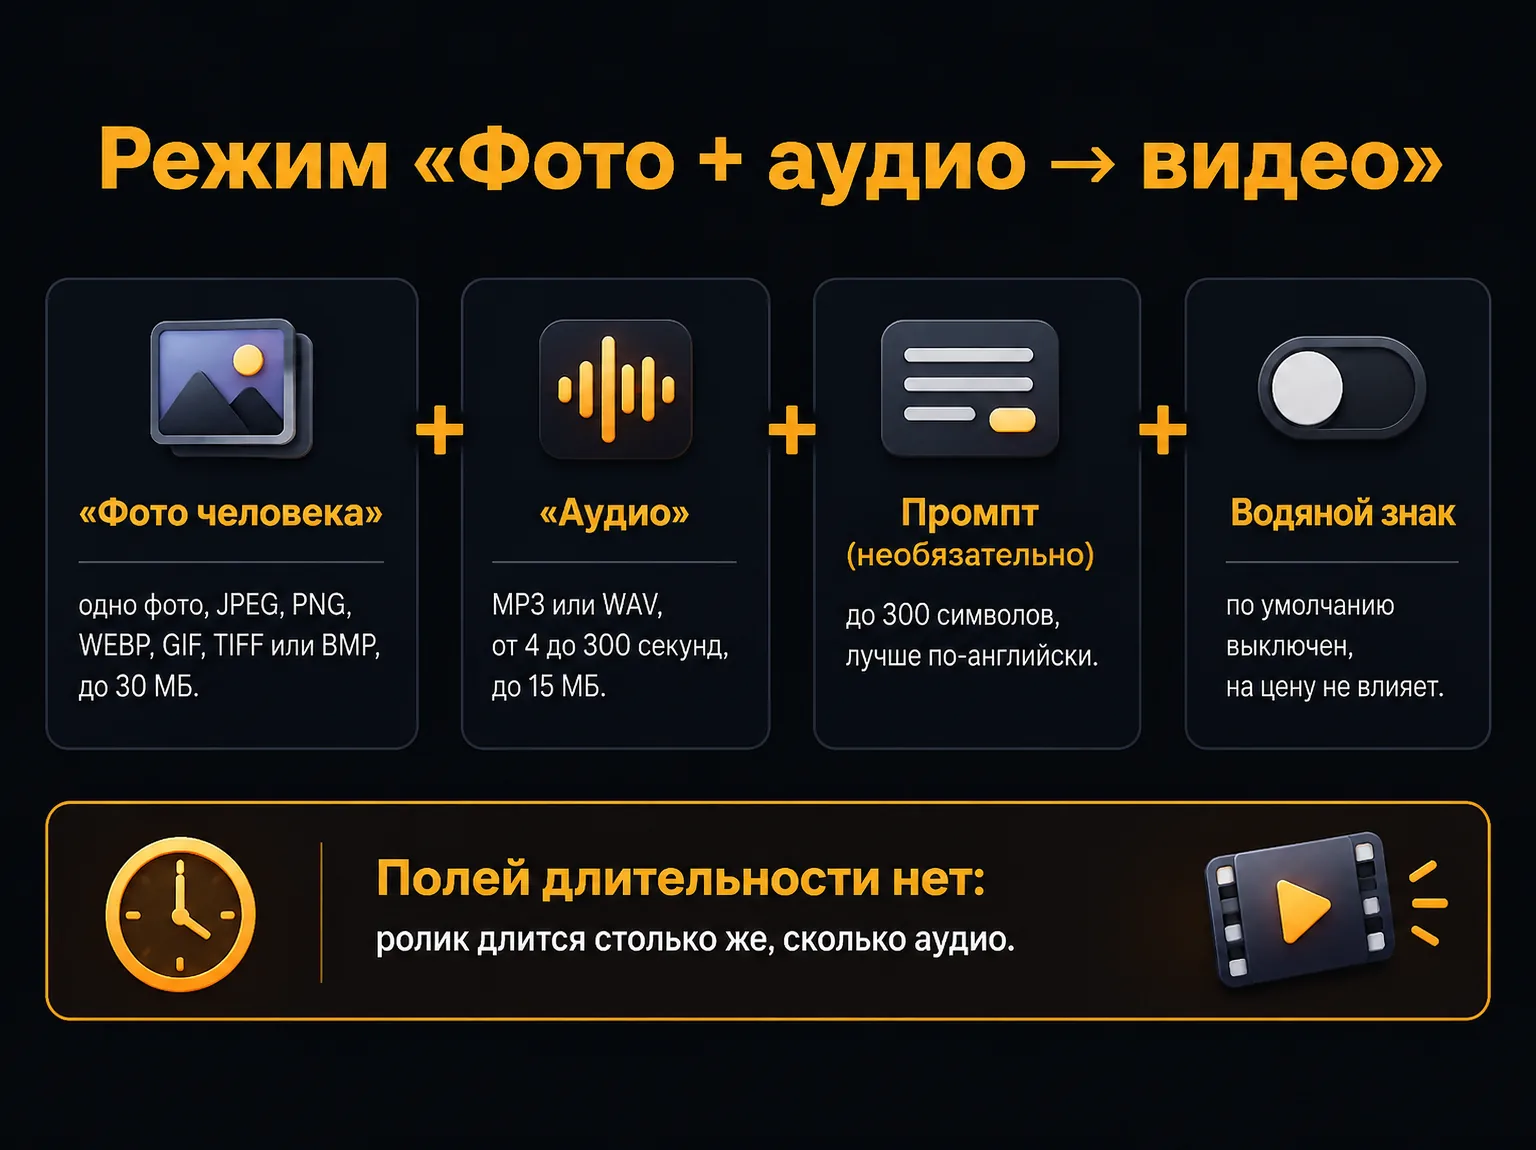
Поля режима «Фото + аудио → видео» и их ограничения в Студии
Наш тест OmniHuman на русской речи: липсинг, лицо и артефакты
В нашем тесте OmniHuman 2.0 синхронизировал губы с русской речью: рот менял форму по ходу фраз, мимика осталась живой, а лицо не исказилось. Ниже все три файла теста — портрет, речь и результат — без обработки.
Портрет мы сгенерировали в IskraGen: человека на фото не существует. Речь озвучили в Gemini 3.1 Flash TTS голосом Kore по русскому тексту. Текст дословно: «Здравствуйте! Меня зовут Анна, я ведущая нашего канала. Сегодня я расскажу вам, как за несколько минут сделать говорящее видео из обычной фотографии и записи голоса. Попробуйте сами — это действительно просто.»
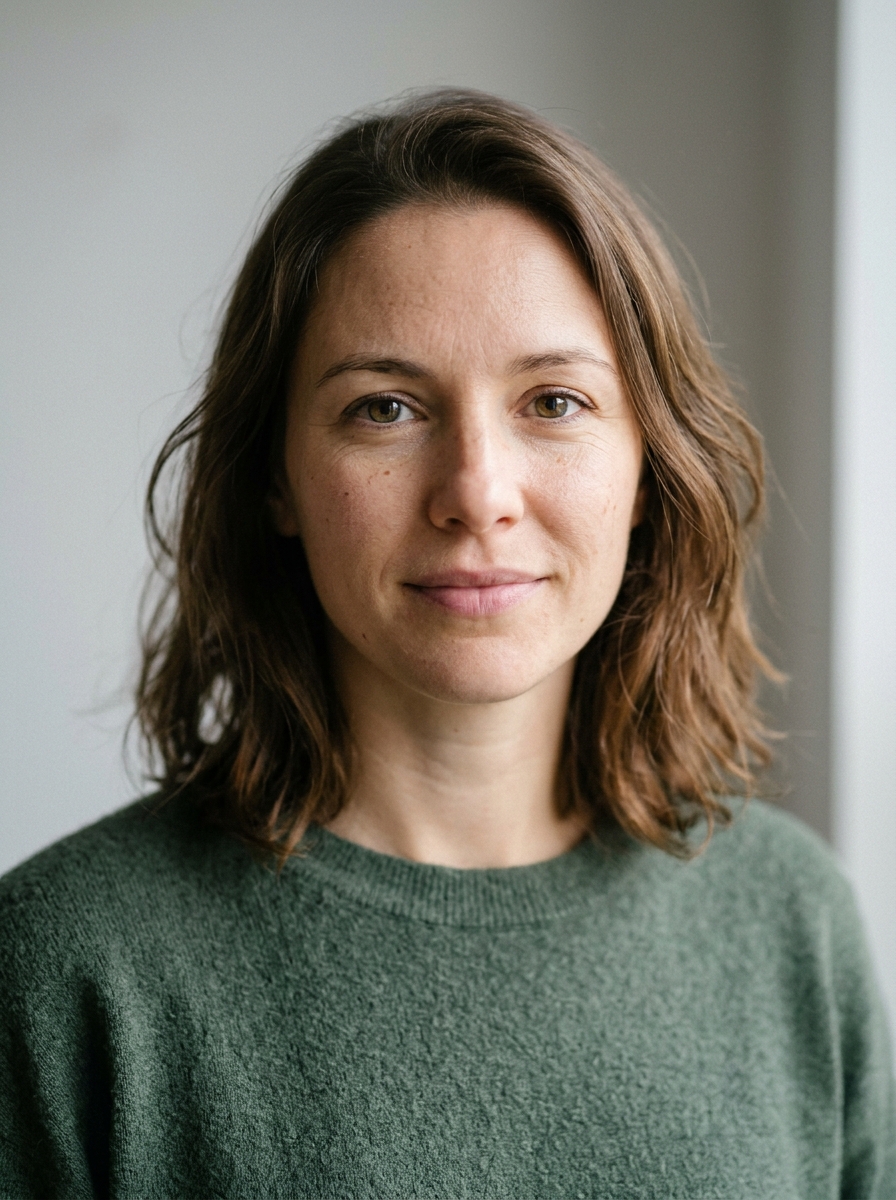
Параметры: аудио 14,7 с (в списание округляется вверх до 15 с), водяной знак выключен, промпт не задан (у модели он необязателен). Цена генерации: 15 с по цене OmniHuman 2.0 14 ₽ за секунду аудио.
Готовый ролик пришёл с разрешением 832×1114, 24 кадра в секунду и длиной ровно 15 секунд. Звуковая дорожка в нём — исходная речь. Файл мы выложили таким, каким его отдал провайдер, без перекодирования.
Липсинг на русской речи. Он есть. Рот меняет форму вслед за звуками: улыбка, округление на «о» и «у», открытый рот. Мимика живая, а ещё модель сама добавила жесты руками, хотя в промпте мы ничего не просили. Чтобы не полагаться на глаз, мы замерили связь между движением области рта и громкостью речи по кадрам. Корреляция вышла 0,24, а для перемешанной речи, где связи быть не должно, — не выше 0,08. Сдвиг по фазе — не больше примерно 0,17 секунды. Так что липсинг нейросеть делает именно под эту запись: движение рта связано с её громкостью, а не случайно.
Лицо. Рот, зубы, нос и глаза без искажений на кадрах с 0,5 по 14,2 секунды. Текстура кожи и причёска сохранились от исходного портрета. Артефактов мы не нашли, хотя смотрели и кадры целиком, и вырезки лица в полном разрешении.
Оговорка, которую важно не прятать. Оценка сделана по кадрам и по замеру корреляции рта с громкостью. Речь на слух не прослушивалась, поэтому про естественность звучания и точность попадания в конкретные звуки на слух мы ничего не утверждаем. Язык речи задаёт наш генератор озвучки по русскому тексту, а длительность 14,72 секунды на 213 знаков согласуется с русской речью.
В нашем тесте OmniHuman хватило портрета и записи голоса, промпт не понадобился.
Сколько стоит OmniHuman 2.0: оплата за секунду аудио
OmniHuman 2.0 14 ₽ за секунду аудио: оплачивается длина загруженной записи, а неполная секунда округляется вверх до целой. Длину аудио меряет сервер, поэтому в счёт идёт фактическая длина записи.
Как это выглядит на практике:
- Минимальный ролик. Аудио короче 4 секунд Студия не примет, поэтому самый короткий запуск — 4 секунды по цене OmniHuman 2.0 14 ₽ за каждую.
- Наш тест. Запись 14,72 секунды округлилась вверх до 15, и списание составило 15 секунд по цене OmniHuman 2.0 14 ₽ за секунду аудио.
- Максимум. Пятиминутная запись даёт 300 оплачиваемых секунд, каждая по той же цене.
Водяной знак на цену не влияет, промпт тоже. Платите вы только за секунды звука.
До того как вы выберете аудио, кнопка запуска в Студии показывает цену минимальной длины — 4 секунды. После загрузки записи сервер измерит её и посчитает итог по фактическим секундам.
Пара советов, как не платить за лишнее:
- Обрежьте тишину. Пауза в начале и в конце записи — тоже секунды, и они попадают в счёт.
- Проверьте запись до загрузки. Модель повторит то, что звучит в файле: оговорку или шум придётся оплачивать заново вместе с новой генерацией.
- Начните с короткого фрагмента. Если сомневаетесь в портрете, прогоните сначала короткий кусок речи, а длинную запись запускайте, когда результат понравится.
Оплата в IskraGen — в рублях, с баланса, без зарубежной карты.
Когда OmniHuman не подойдёт и что выбрать вместо него
OmniHuman хорош, когда у вас уже есть запись голоса и портрет, а нужно, чтобы человек на фото произнёс именно её. В остальных случаях удобнее другие инструменты.
Нет записи голоса. Если голоса нет, есть два пути. Первый — сделать запись озвучкой текста и отдать её в OmniHuman, как сделали мы. Второй — взять видеомодель, которая сама озвучивает реплику прямо из промпта. Какие модели говорят по-русски и как писать для них реплики, разобрано в статье как оживить фото со звуком.
Нужно движение без речи. Если портрету достаточно улыбнуться, повернуть голову или моргнуть, синхронизация губ не нужна. Тогда подойдёт обычная модель «картинка в видео», где движение описывается промптом. Как выбрать снимок и что писать в промпте, рассказываем в статье как оживить фото нейросетью.
Нужно разрешение выше 720p. OmniHuman 2.0 по описанию провайдера отдаёт 720p. Для крупных экранов это стоит учитывать заранее.
Хотите управлять сценой словами по-русски. Промпт у OmniHuman понимает ограниченный набор языков, и русского среди них нет. Если сцену хочется описывать подробно и по-русски, удобнее видеомодели с текстовым промптом.
Итого: говорящее фото нейросеть OmniHuman делает лучше всего тогда, когда главное в ролике — речь. Есть портрет и голос — запускайте OmniHuman 2.0 в Студии. Нет голоса или нужна сцена без слов — смотрите на модели «картинка в видео».
Частые вопросы
Попробовать OmniHuman 2.0 в IskraGen
Генерация без VPN, оплата в рублях через СБП. Первые генерации — за минуту.
100 ₽ в подарок при регистрации
Похожие статьи
GPT Image Sunburst, Flare и Economy: версии GPT Image 2.6 и наш тест
5 ноября 2026 · 11 мин чтения
Seedance 2.5 против Seedance 2: что изменилось и сколько стоит
31 октября 2026 · 9 мин чтения
FLUX 3 Klein: быстрая нейросеть для картинок по тексту и цена
25 октября 2026 · 9 мин чтения
Kling 4.0 и Kling 4.0 Flash: видео по референсам и кадрам — тесты
25 октября 2026 · 16 мин чтения
PixVerse AI (Пиксверс) V6 Max: видео по тексту и по фото в рублях
25 октября 2026 · 10 мин чтения