Нейросеть на русском языке: интерфейс, промпт и надписи в кадре
Промпт
Horizontal blog cover, photoreal interior scene. Background: dark night room, deep charcoal tones #0A0A0F, large window on the right showing a snowy Russian panel apartment block outside. Subject: a designer's desk with a monitor and a graphics tablet, the monitor glowing with a soft violet #7C3AFF light that spills over the desk and wall. Details: matte plastic and brushed metal, thin violet rim light, faint dust in the air, cold window light mixing with warm desk lamp, photorealistic, 35mm, shallow depth of field, slight film grain. Composition: 16:9, desk in the lower-left two thirds, clean dark negative space in the upper-left for a headline, eye-level angle. Constraints: screens show only abstract violet gradients and shapes, absolutely NO text, NO letters, NO logos, NO numbers, NO watermark, no people. Use: cover image for a blog article about AI image generation in Russian. Стиль: тёмный фон #0A0A0F, акцентный фиолетовый #7C3AFF, крупный рубленый шрифт, без водяных знаков.
Главное:
- Фраза «нейросеть на русском языке» скрывает три разных запроса: интерфейс, промпт и надпись в кадре.
- Русский промпт модели разбирают: Кандинский обучен на русских описаниях, Шедеврум изначально русскоязычный.
- Кириллица надписью внутри картинки — самое слабое место: разработчики заявляют латиницу и иероглифы.
- Мультиязычный текст в кадре официально обещает только Google в семействе Nano Banana.
- В каталоге IskraGen интерфейс русский, оплата в рублях, картинки — от 3 ₽ за генерацию.
Когда человек ищет, где найти нейросеть на русском языке, он обычно имеет в виду одно из трёх — и сам этого не разделяет. Кому-то нужны русские кнопки и подсказки, кому-то — чтобы модель поняла описание, написанное по-русски, а кому-то — чтобы на готовой картинке ровно читалась русская надпись. Это три разные технические задачи, и решаются они в разных местах, хотя в поиске все три сходятся в одну фразу — нейросеть на русском языке. Ниже разбираем каждую по документации разработчиков, а не по ощущениям из подборок.
Нейросеть на русском языке — это три разных запроса
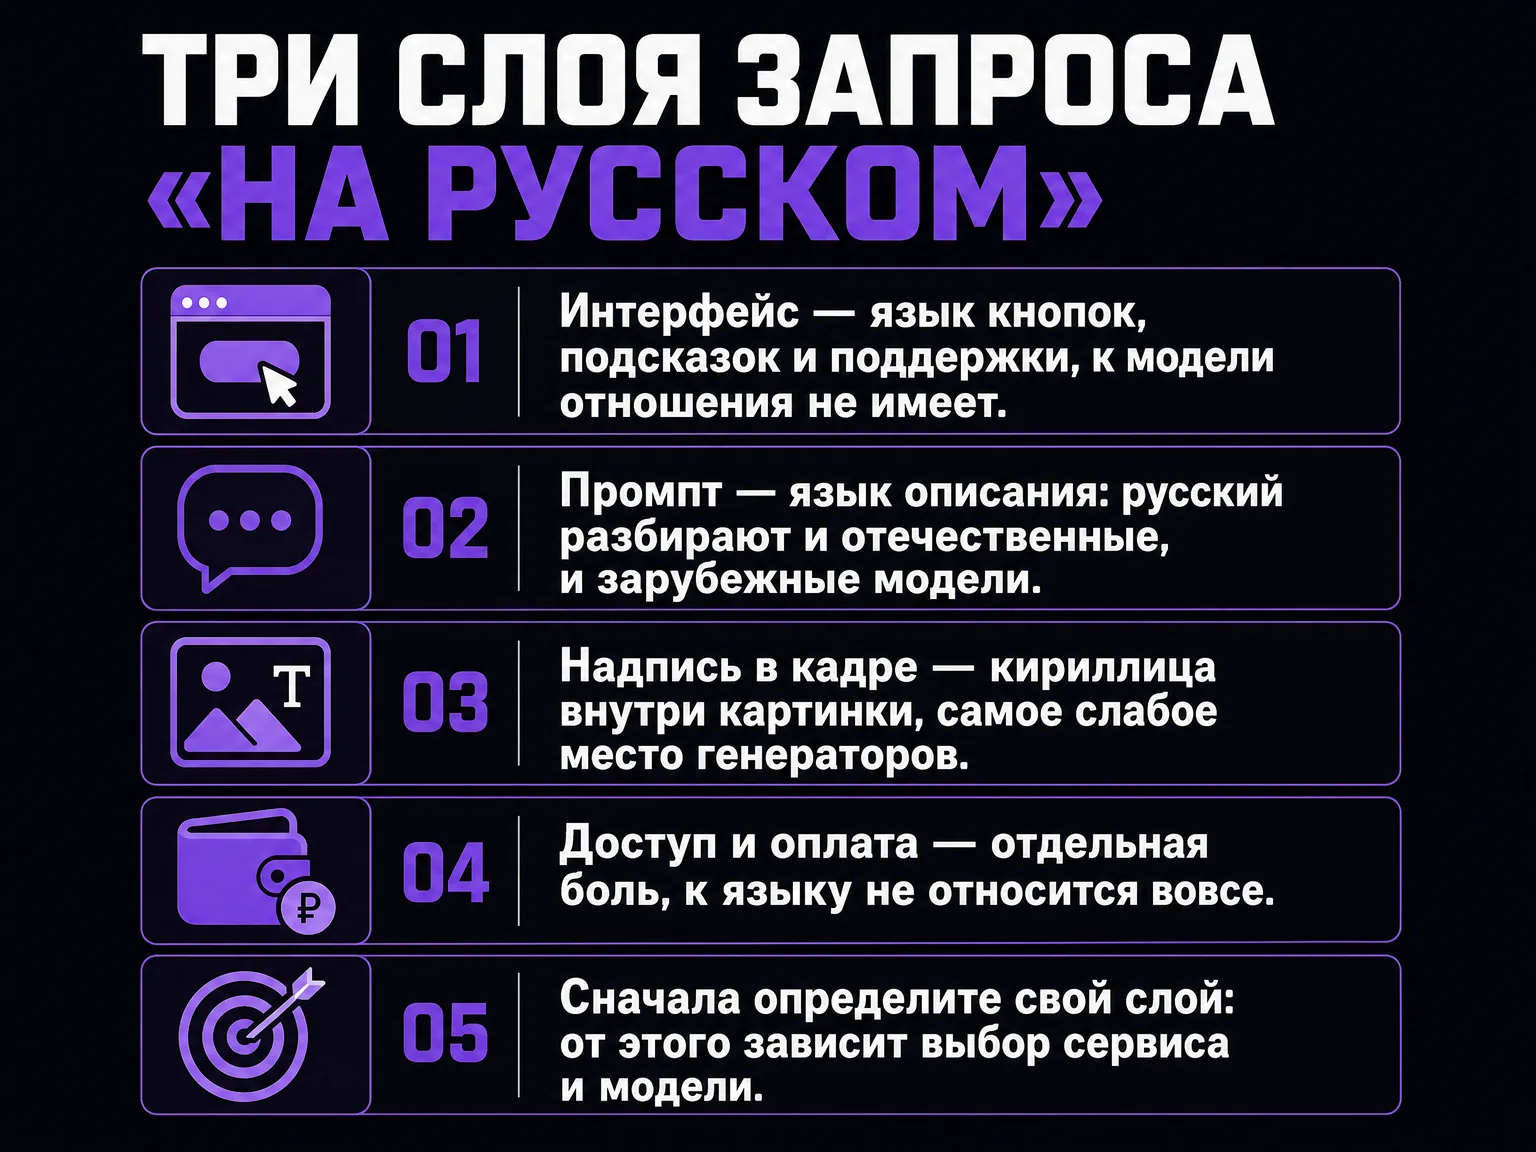
Нейросеть на русском языке может означать русский интерфейс сервиса, понимание русского промпта моделью или кириллицу надписью внутри картинки. Эти три слоя не связаны между собой, и путаница между ними — главная причина разочарований.
Первый слой — интерфейс. Это язык кнопок, подсказок, справки и переписки с поддержкой. Он живёт на стороне сервиса и к самой модели отношения не имеет: одна и та же модель спокойно работает и под русскими надписями в панели, и под английскими. Если вам нужен только понятный личный кабинет, выбор шире, чем кажется: нейросеть на русском языке в этом смысле есть и у отечественных сервисов, и у агрегаторов зарубежных моделей.
Второй слой — язык запроса. Здесь решает модель: как она разбирает текст описания и насколько точно переводит его в изображение. Разработчики почти никогда не публикуют список поддерживаемых языков промпта, поэтому проверка идёт эмпирически — одной генерацией.
Третий слой — текст внутри кадра, и именно он чаще всего обманывает ожидания от фразы «нейросеть на русском языке». Самая сложная часть, потому что модель не набирает буквы шрифтом, а рисует их как часть картинки. Именно здесь кириллица отстаёт от латиницы сильнее всего, и никакие русские кнопки этого не исправляют.
Отдельная, четвёртая боль прячется рядом: доступность сервиса и оплата из России. Она к языку не относится вовсе, хотя в поиске часто соседствует с ним — про это есть разбор какие нейросети работают без VPN.
Прежде чем выбирать сервис, полезно честно ответить себе, какой именно слой болит. От ответа зависит всё: для первого достаточно любого сервиса с русской панелью, для второго придётся сравнить модели, а для третьего — заранее готовиться к дублям и запасному плану.
Четыре слоя, которые прячутся за фразой «нейросеть на русском языке»
Понимает ли нейросеть на русском языке текст промпта
Да, русский промпт современные модели разбирают, и для генераторов изображений это давно норма. Нейросеть на русском языке принимает описание как есть, а качество результата сильнее зависит от конкретики формулировки, чем от выбранного языка.
Надёжнее всего это задокументировано у российских моделей. В репозитории Kandinsky 5.0 поддержка русского вынесена отдельной строкой возможностей — «понимание русских концептов», а видеомодель, по описанию авторов, генерирует ролики «из английских и русских промптов». Технический отчёт того же поколения, опубликованный в ноябре 2025 года, добавляет деталей: модели предобучены на английских и русских текстовых описаниях, а в обучающий набор вошли 768 555 изображений «русского культурного кода» с описаниями, написанными по-русски вручную. Шедеврум «Яндекса» изначально построен вокруг русскоязычного пользователя: интерфейс доступен на русском, английском и казахском.
С зарубежными моделями ситуация другая, и её стоит понимать точно. Ни OpenAI, ни Google, ни Alibaba, ни ByteDance не публикуют перечень языков промпта — в документации такого списка просто нет. Отсутствие списка не равно отсутствию поддержки: Google в описании Nano Banana Pro отдельно упоминает «расширенное мультиязычное рассуждение» модели. Но гарантии в документах тоже нет, поэтому русский промпт для незнакомой модели проверяется одной дешёвой генерацией, а не верой в обзор.
Практика простая. Для генератора картинок нейросеть на русском языке — обычный рабочий режим, и формулировка решает больше, чем язык: «женщина 35 лет в синем пальто на фоне мокрой набережной, пасмурный день, средний план» сработает и по-русски, и по-английски, а «красивое фото девушки» не сработает никак. Английские термины иногда выручают в узких местах — названия стилей, оптики, приёмов съёмки: bokeh, long exposure, isometric. Их можно вставлять прямо в русский текст, модели это не мешает. Подробные схемы разбора описаний собраны в материале про промт для фото нейросети.
Ещё одна деталь, о которой редко пишут: имена собственные и топонимы модель знает неравномерно. «Хохлома», «панельная девятиэтажка», «сталинский ампир» отечественные модели передают заметно вернее зарубежных — сказывается тот самый набор данных про русский культурный код.
Надписи кириллицей в кадре: где всё ломается
Кириллица внутри картинки выходит хуже латиницы, потому что разработчики оптимизируют отрисовку текста под английский и китайский, а русский в заявленные возможности почти не попадает. Нейросеть на русском языке уверенно понимает запрос, но рисует буквы ответа наугад. Это видно прямо в документации моделей.
Возьмём Qwen-Image от Alibaba — модель, которая делает ставку на текст в кадре. Её карточка на Hugging Face обещает высокую точность для «алфавитных языков вроде английского» и «логографических вроде китайского». В техническом отчёте, вышедшем в августе 2025 года, формулировка та же: отлично для английского, значительный прогресс для китайского. Других письменностей в списке нет — не потому, что они запрещены, а потому, что за них никто не ручается.
OpenAI в руководстве по генерации изображений признаёт ограничение открыто: «модель всё ещё может испытывать трудности с точным размещением и чёткостью текста» — и это сказано про латиницу. ByteDance для Seedream 4.0 сообщает о высоких оценках по отрисовке текста, но какие именно языки проверялись, не уточняет.
Самое показательное свидетельство пришло от российской модели. В отчёте Kandinsky 5.0 описано, как чистились обучающие подписи: «дальнейшая фильтрация удаляет предложения, содержащие нелатинские символы (например, кириллицу, китайский)». То есть кириллические строки целенаправленно вычищались из подписей ради качества английских описаний — и модель их почти не видела.
Исключение одно, и оно задокументировано. Google в анонсе Nano Banana Pro называет модель лучшей для изображений с корректно отрисованным читаемым текстом и отдельно заявляет мультиязычность: можно генерировать текст на разных языках, локализовать и переводить содержимое картинки. Документация Gemini API подтверждает это отдельным пунктом про «продвинутую отрисовку текста» — для инфографики, меню, схем и рекламных материалов — и советует описывать в промпте и сам текст, и стиль шрифта.
Что из этого следует на практике:
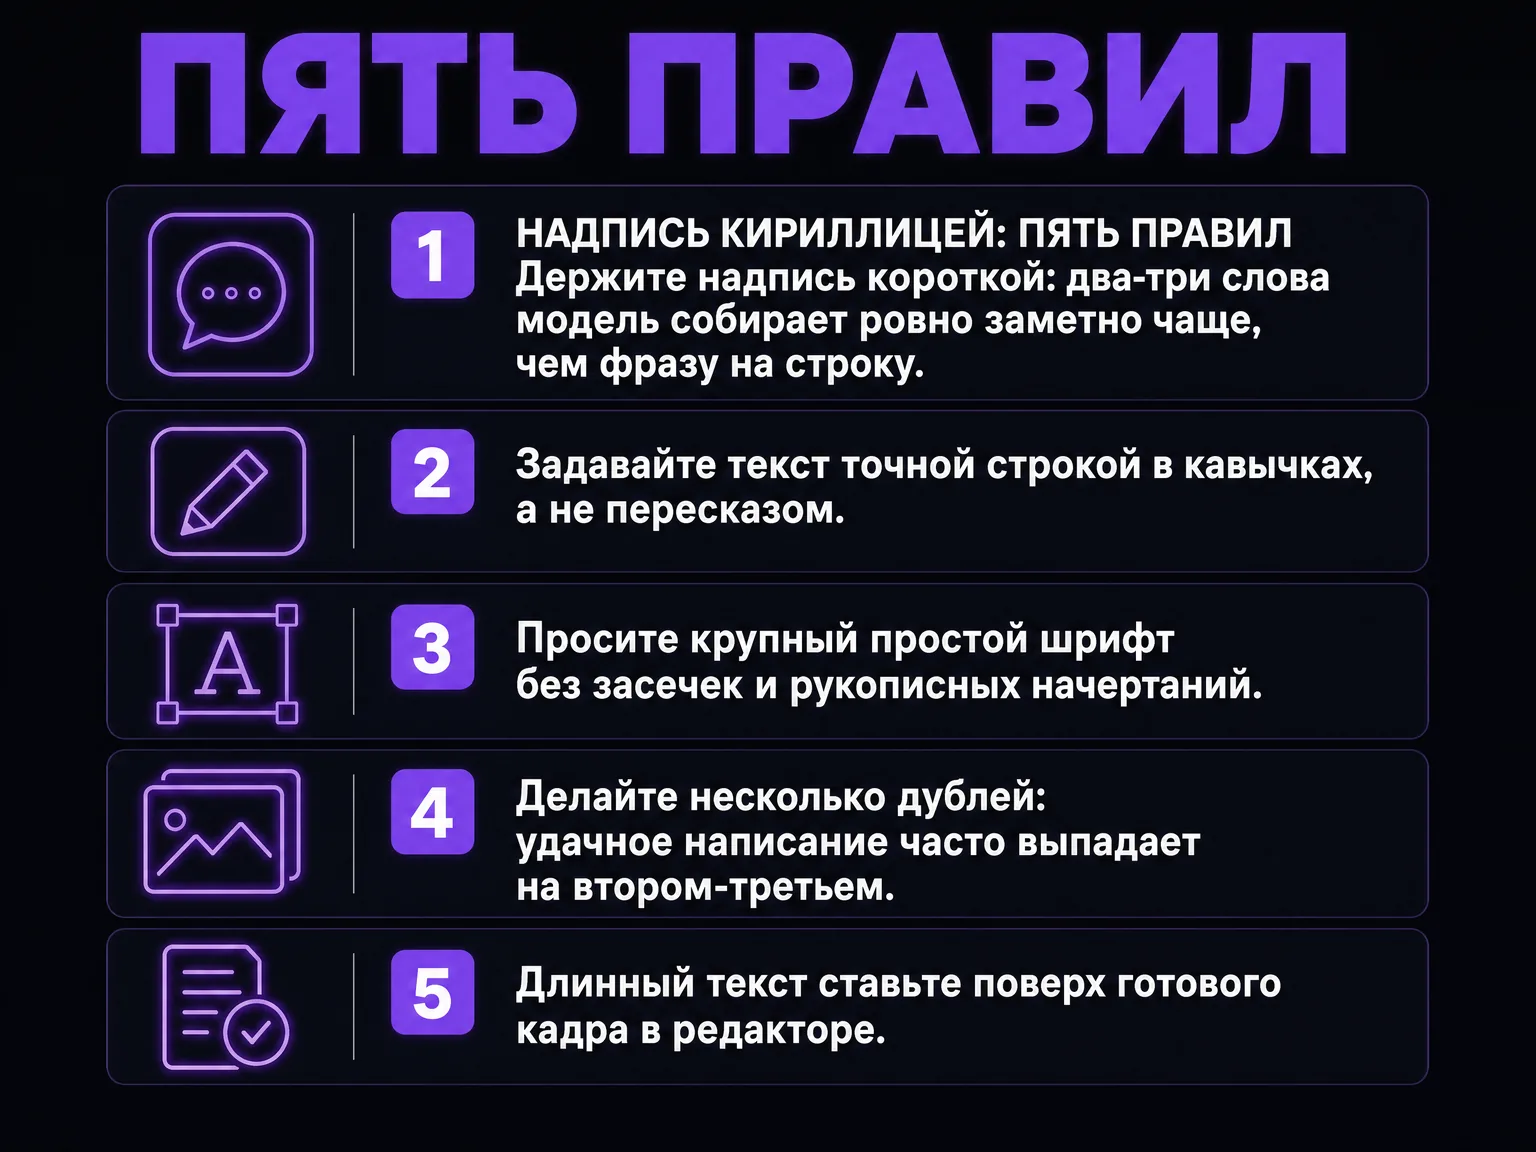
- Держите надпись короткой. Два-три слова модель собирает ровно заметно чаще, чем фразу на строку.
- Задавайте текст точной строкой в кавычках:
надпись "Открыто" на вывеске. Пересказ вместо цитаты модель дорисовывает по-своему. - Просите крупный простой шрифт без засечек и рукописных начертаний — мелкие декоративные буквы плывут первыми.
- Делайте несколько дублей одного промпта: удачное написание часто выпадает на втором-третьем.
- Длинный текст добавляйте поверх готового кадра в редакторе — так работают и с инфографикой, разбор есть в статье про нейросеть для инфографики.
Отдельный приём — сгенерировать картинку с пустым местом под надпись: табличка, баннер, поле на упаковке. Пустую плашку модель рисует чисто, а текст вы ставите сами и контролируете шрифт полностью.
Пять приёмов, которые повышают шанс на ровную русскую надпись
Русские нейросети для генерации изображений: Шедеврум и Кандинский
Русские нейросети для генерации изображений — это прежде всего Шедеврум «Яндекса» и Кандинский «Сбера», и обе закрывают вопрос интерфейса полностью. Нейросеть на русском языке отечественной разработки понимает запрос без переводчика. Различаются они зрелостью линейки и тем, что доступно снаружи.
Шедеврум — проект, сервис и приложение «Яндекса». Прототип показали 5 апреля 2023 года, официальный релиз с языковой моделью YandexGPT состоялся 15 июня 2023 года, а генерация видео появилась 28 августа того же года. Интерфейс работает на русском, английском и казахском: по справке сервиса, картинки и ролики создаёт YandexART, тексты — YandexGPT. Ограничения по содержанию запросов описаны отдельным разделом справки — под рабочие задачи это обычно не мешает, под мемы про публичных персон мешает сразу.
Кандинский — российская линейка с открытым кодом, и её актуальное поколение описано в отчёте от 19 ноября 2025 года. Kandinsky 5.0 — это семейство: Image Lite на 6 млрд параметров для картинок, отдельная модель редактирования на 6 млрд, Video Lite на 2 млрд и Video Pro на 19 млрд для видео. Код и чекпойнты опубликованы, а «понимание русских концептов» авторы называют сильной стороной линейки в открытой экосистеме.
У отечественного пути есть честный минус: набор моделей внутри сервиса один, и выбирать между архитектурами не приходится. Если результат не устраивает, переключиться не на что — остаётся менять формулировку. Агрегатор решает ровно эту проблему: русская панель остаётся, а моделей под ней несколько, и одну и ту же сцену можно прогнать через разные.
Для видеозадач расклад отличается, там свои лидеры и свои ограничения, — отдельный разбор собран в материале про русские нейросети для генерации видео.
Как выбрать модель под свою задачу и сколько это стоит
Выбирать стоит от задачи: без текста в кадре подойдёт любая быстрая модель, с надписью — те, у кого отрисовка текста заявлена отдельно. Нейросеть на русском языке в каталоге IskraGen — это русский интерфейс и документация плюс выбор из нескольких генераторов, оплата идёт в рублях, без зарубежной карты.
Разбивка по сценариям выглядит так:
- Картинка без надписей, черновики и варианты: Nano Banana 2 Lite — от 3 ₽ за генерацию.
- Иллюстрация с короткой надписью: Google - Nano Banana 2 — от 7 ₽, у семейства мультиязычный текст заявлен разработчиком.
- Плакат, обложка, карточка с типографикой: Seedream 5.0 Pro — Текст в картинку от 7 ₽, аккуратная вёрстка текста указана в описании модели.
- Точный текст и правка по референсу: Qwen Image 3.0 — Текст в картинку от 5 ₽.
- Фотореалистичный кадр и локальные правки: GPT Image 2 — Text to Image от 5 ₽.
- Выраженный художественный стиль: Midjourney — от 14 ₽ за генерацию, четыре варианта за один запуск.
Порядок работы, который экономит деньги и нервы. Сначала прогоните сцену на модели за 3 ₽ и убедитесь, что композиция та. Потом переносите тот же промпт на модель с текстом и добавляйте надпись. И только если надпись упорно ломается, снимайте её из промпта и ставьте поверх кадра в редакторе — результат предсказуемее любых дублей.
Стартовый баланс в каталоге позволяет пройти этот цикл целиком: пара черновиков, пара финальных кадров и проверка надписи обойдутся в несколько десятков рублей. Оплата картами российских банков и через СБП, счета и акты для юрлиц выставляются в кабинете, поддержка отвечает по-русски.
Итог по трём слоям, из которых складывается нейросеть на русском языке. Русский интерфейс — вопрос выбора сервиса и решается сразу. Русский промпт — рабочая норма, отечественные модели обучены на русских описаниях напрямую. Кириллица в кадре — единственное место, где придётся закладывать дубли и запасной план, и здесь выигрывает тот, кто заранее знает про ограничение, а не обнаруживает его после десятой генерации.
Частые вопросы
Попробовать Google - Nano Banana 2 в IskraGen
Генерация без VPN, оплата в рублях через СБП. Первые генерации — за минуту.
Похожие статьи

Нейросеть для генерации изображений: от промпта до кадра
19 августа 2026 · 8 мин чтения
Аналог Nano Banana: какие модели редактируют фото словами
20 сентября 2026 · 9 мин чтения
Аналог Суно: чем заменить и где платить за музыку рублями
20 сентября 2026 · 9 мин чтения
Higgsfield: что за нейросеть для видео и чем её заменить
20 сентября 2026 · 10 мин чтения
Midjourney подписка: тарифы, оплата из России и цена кадра
20 сентября 2026 · 9 мин чтения